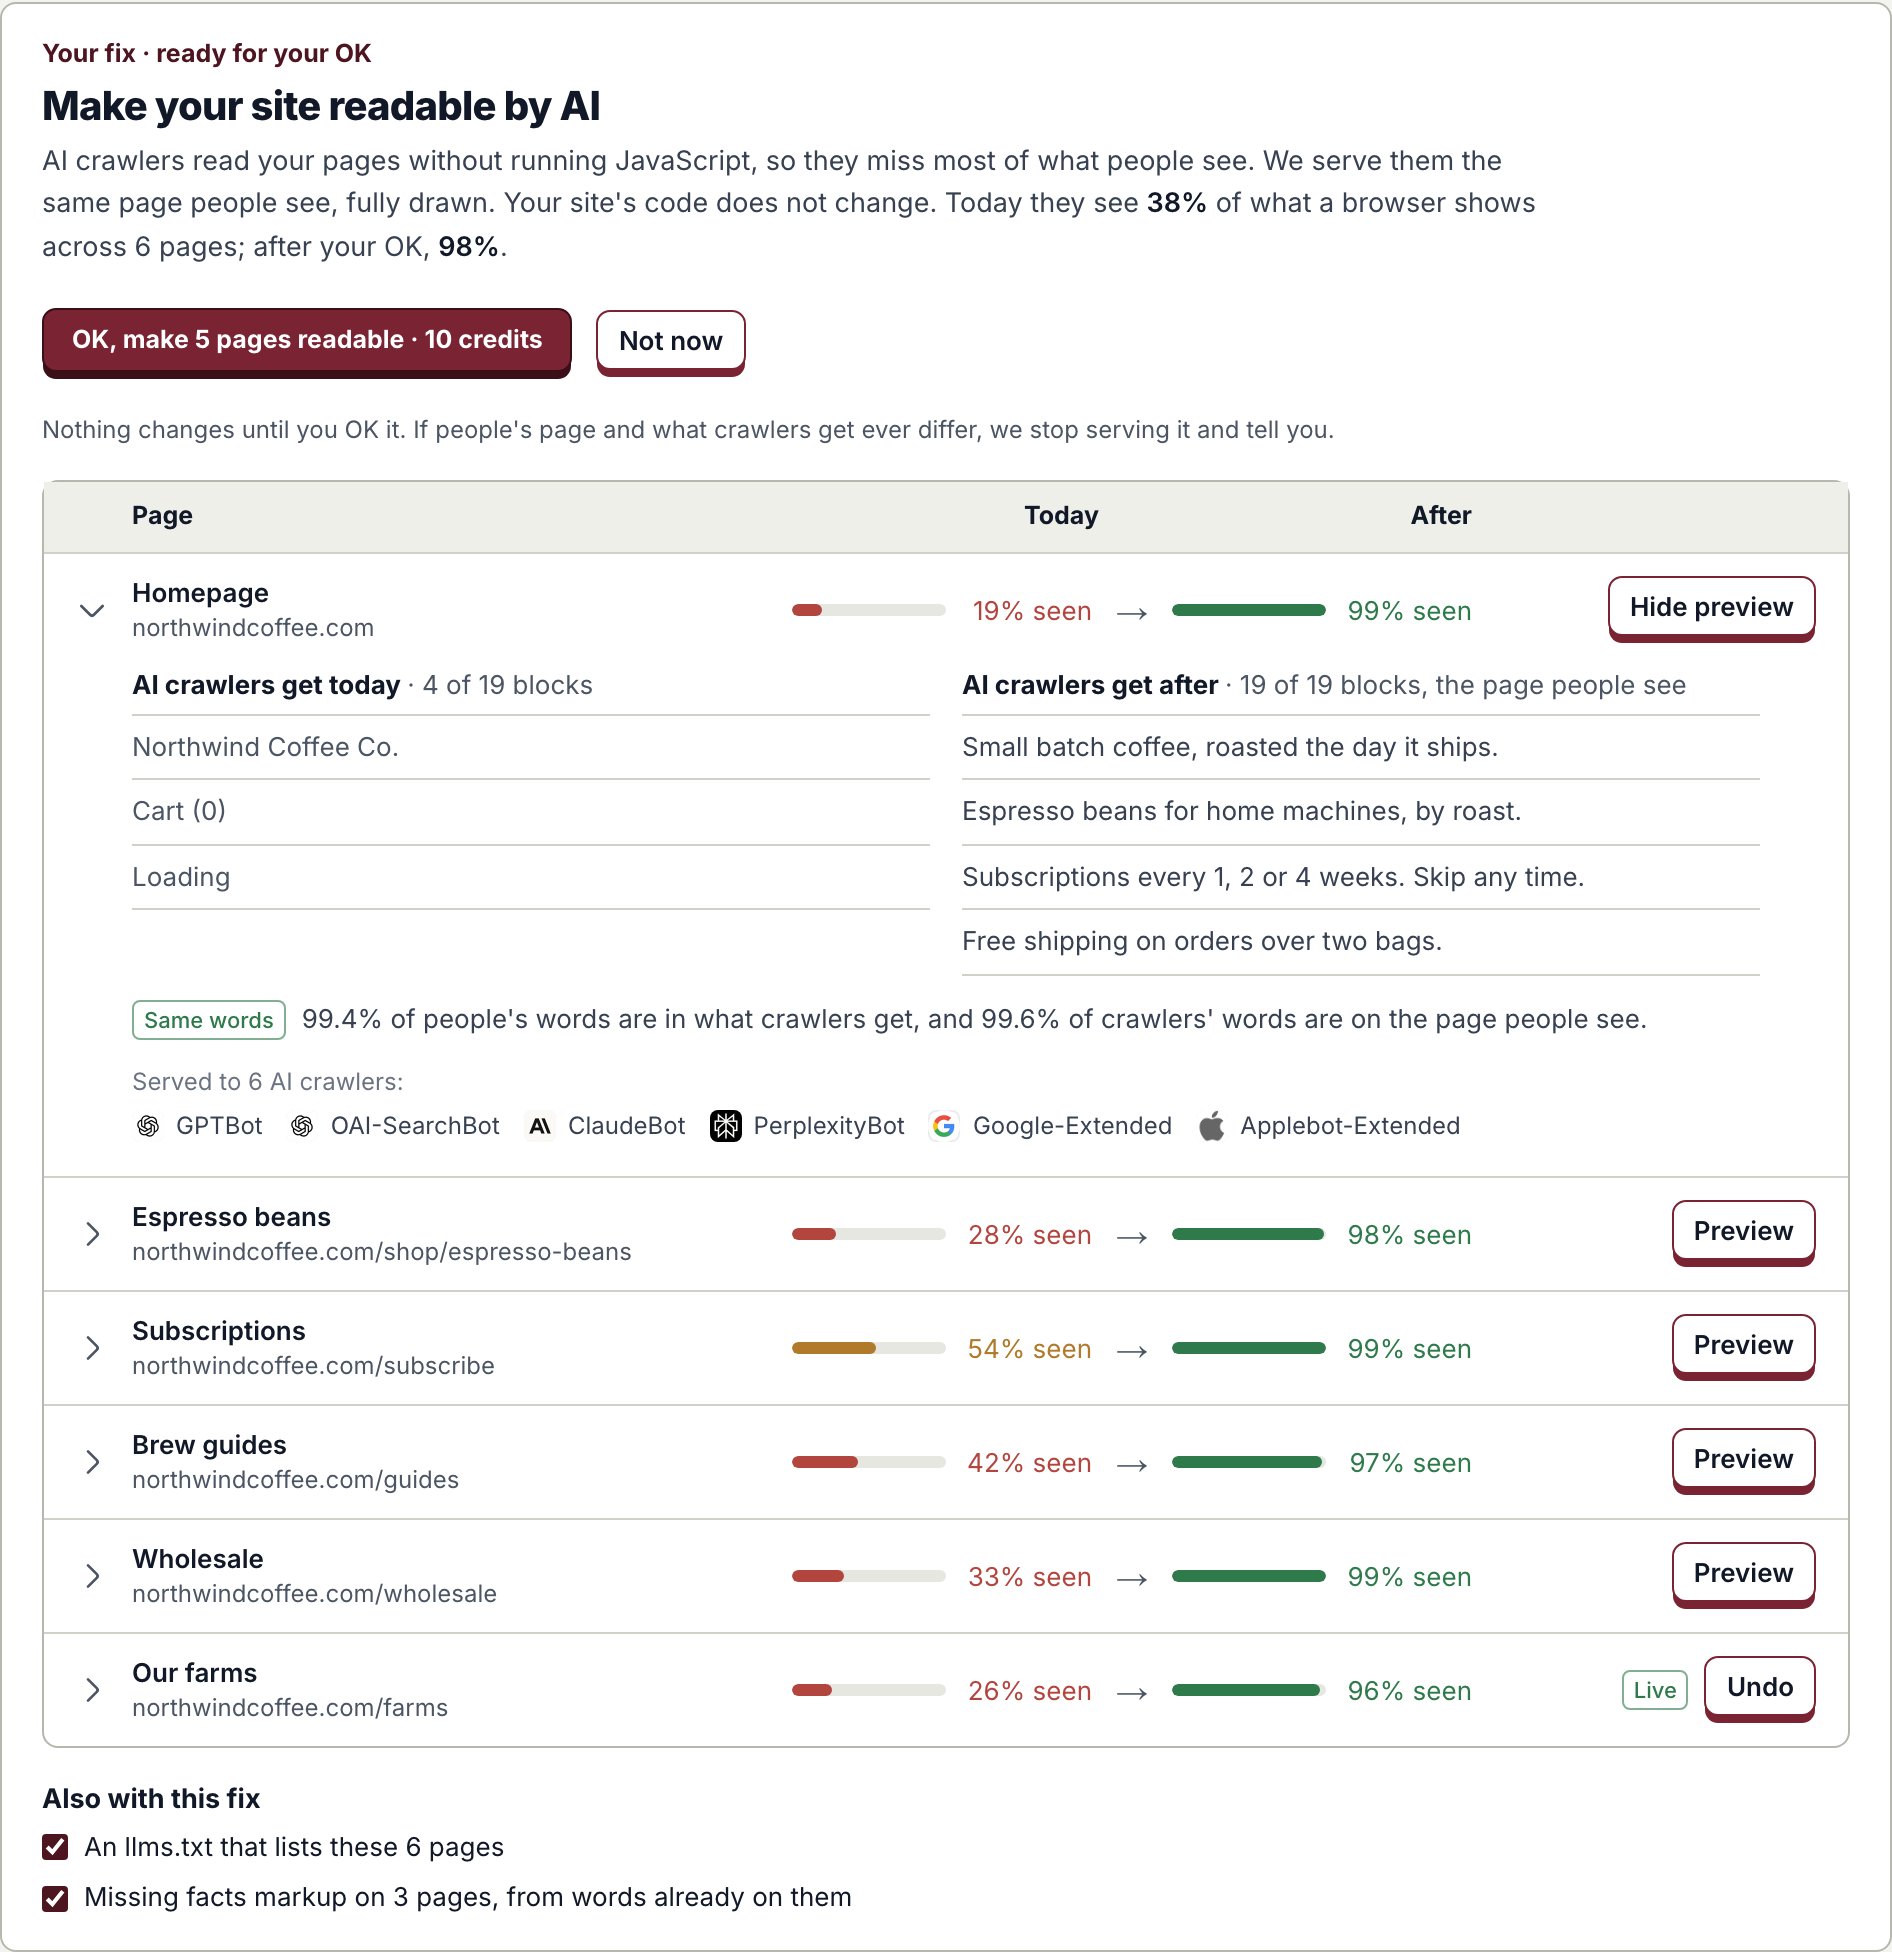
逐頁查看 AI 爬蟲漏掉了什麼。
對於您的首頁以及 AI 最常引用的頁面,Proofsource 會比較爬蟲取得的內容與瀏覽器顯示的內容。分數是使用者看到的文字中,爬蟲也取得的比例。
- 每個頁面一個分數,而不是整個網站一個數字
- AI 最常引用的頁面排在最前面
- 無法讀取的頁面會說明原因,絕不顯示 0%
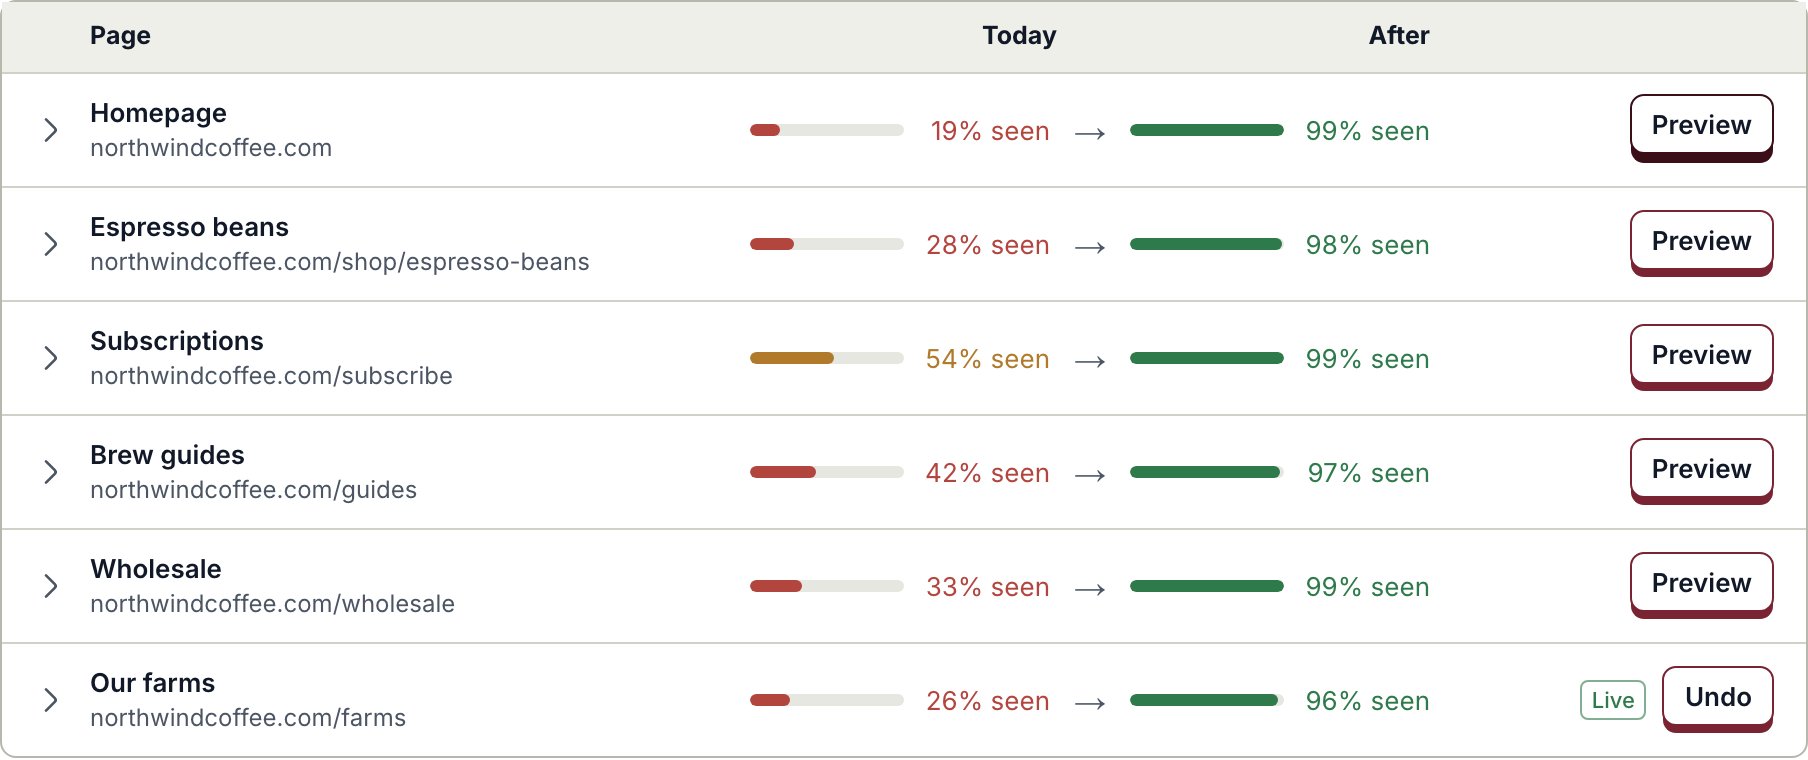
與使用者看到的文字相同。絕不是專為 AI 製作的頁面。
在您同意前,可以逐個區塊預覽每個爬蟲目前與之後取得的內容。修正後,AI 會取得您真實、完整呈現的頁面:文字相同,標記更簡潔。如果兩者出現差異,我們就會停止提供。
- 任何內容上線前都會雙向檢查文字
- 提供給 GPTBot、ClaudeBot、PerplexityBot 及其他 AI 爬蟲
- 使用者和搜尋引擎看到的網站維持原樣
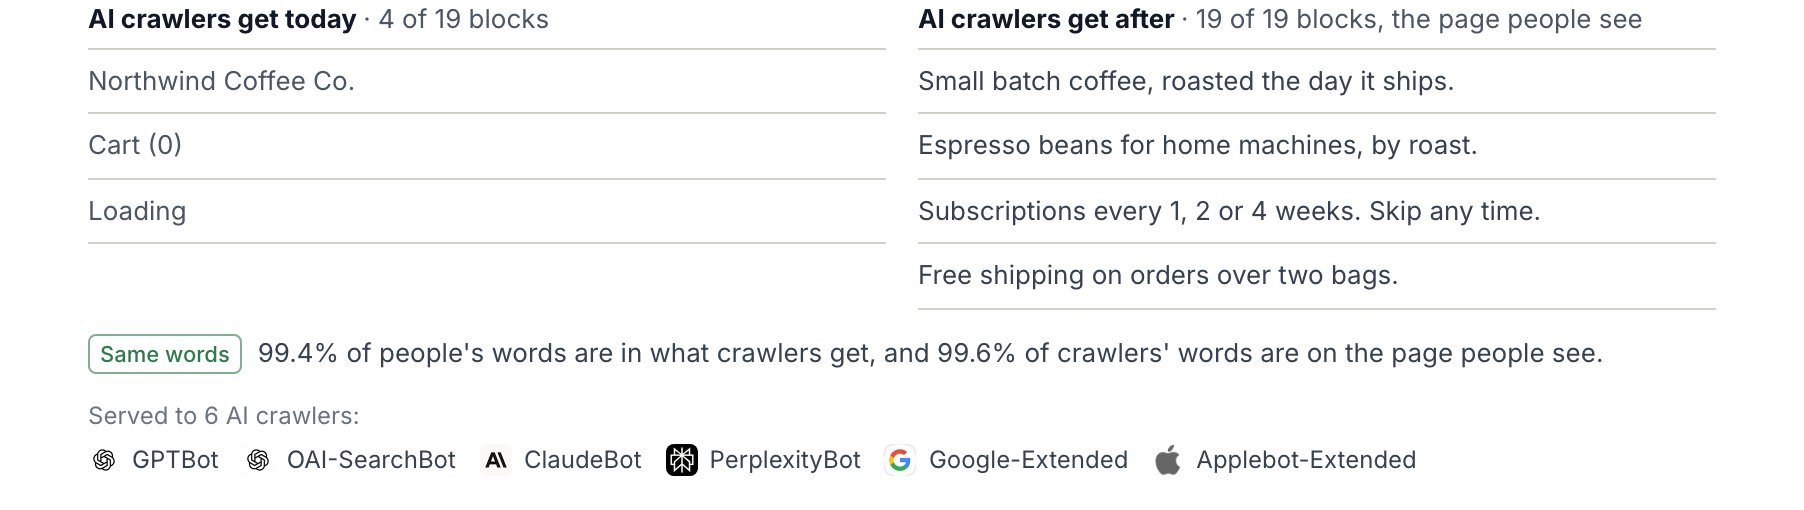
是證明,不是承諾。
每項修正都在「結果」中證實:每個頁面之前與現在的分數、AI 爬蟲讀取可讀頁面的次數,以及 AI 是否在比以前更多的回答中提到您。
- 每個頁面的之前與現在
- 每天重新檢查文字是否相同
- 一鍵復原任何頁面
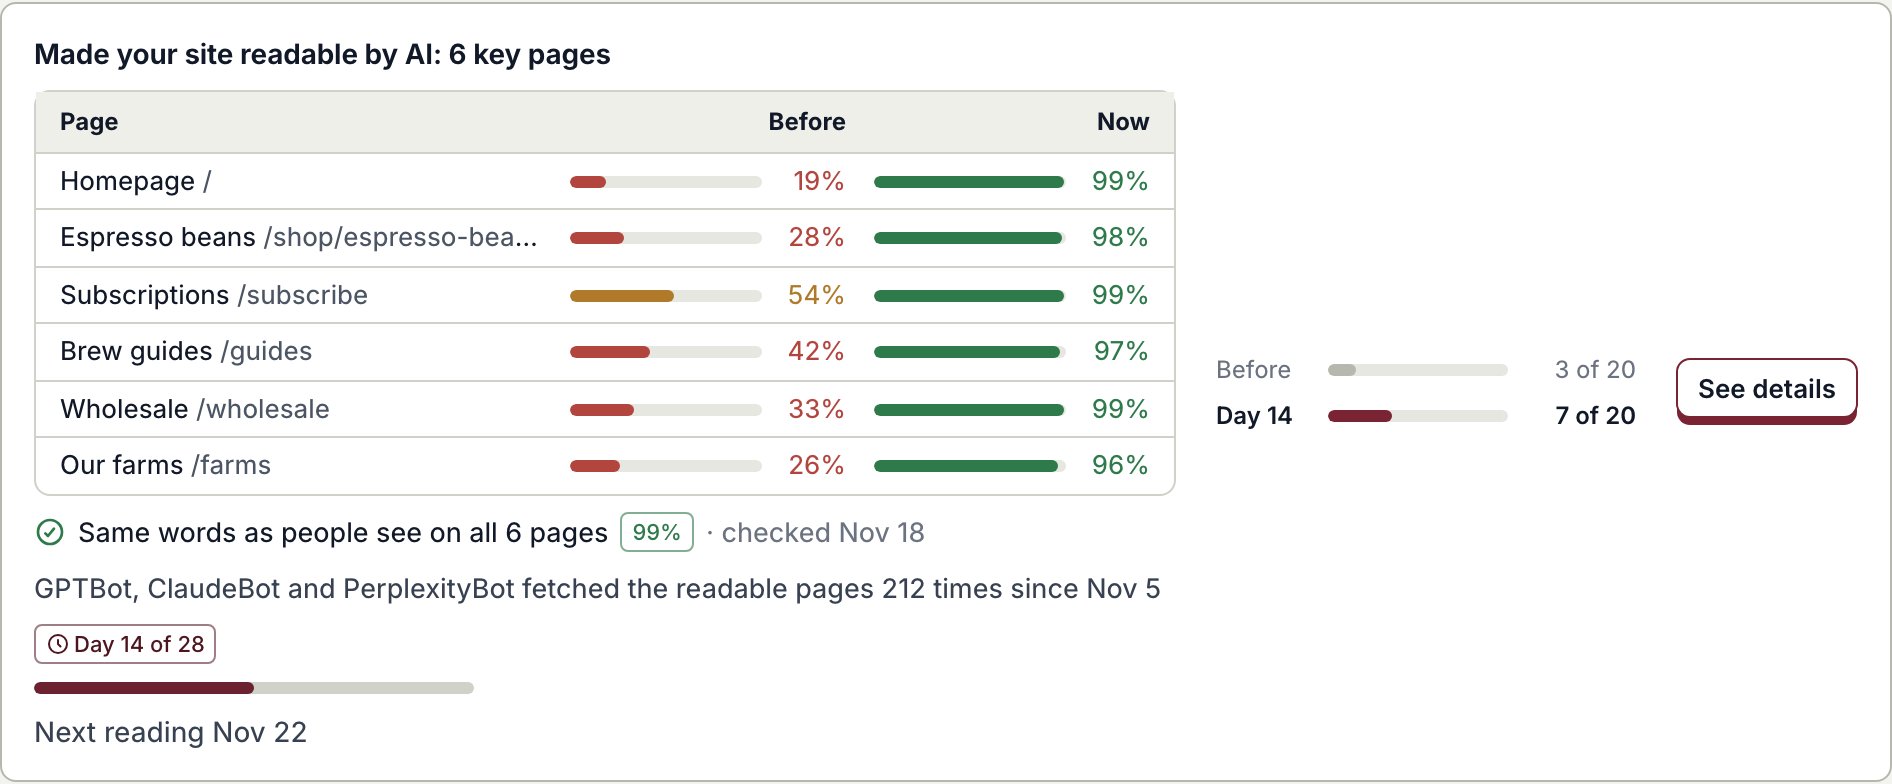
打造得能安全運行於您真實的網站上。
在您同意前不會有任何變動
您會先看到每個頁面及其預覽。同意一次即涵蓋全部,而且每個頁面在開始前都會顯示所需的點數。
您的程式碼維持原樣
可讀版本由您網站前端提供。您的頁面、建置與使用者看到的內容都不會改變。
一鍵復原
任何頁面都能隨時恢復原狀。若頁面的文字與線上頁面出現偏差,會自動復原。
買家會問的問題
這算是偽裝(cloaking)嗎?
不是。偽裝是讓爬蟲看到與使用者不同的內容。Proofsource 提供給 AI 爬蟲的文字與使用者看到的相同,在頁面上線前及之後每天都會雙向檢查,一旦出現差異就停止。
為什麼 AI 爬蟲目前讀不到我的網站?
許多 AI 爬蟲只讀取您的伺服器傳送的 HTML,不會執行 JavaScript。如果您的文字只有在 JavaScript 執行後才出現,這些爬蟲取得的就幾乎是一個空白頁面。
我需要開發人員嗎?
不需要。連接您網站的主機後,同意一次就能讓每個重要頁面都可被讀取。您的程式碼完全不會變動,而且您可以自行復原任何頁面。
包含哪些頁面?
您的首頁、首頁最常連結的頁面,以及 AI 已經引用的頁面。在您同意任何事情前,您會看到這份清單與每個頁面的分數。
我怎麼知道有沒有效?
「結果」會顯示每個頁面之前與現在的爬蟲分數、AI 爬蟲讀取可讀頁面的次數,以及 AI 是否在更多回答中提到您。


